Serien und Filme tracken — selbst gehostet, ohne fremde Konten.
Episodenfortschritt, eigene Universen mit mehreren Reihenfolgen, Statistiken
und Benachrichtigungen, wenn es weitergeht.
---
**Flimmer** ist ein selbst hostbarer Tracker für Serien und Filme — benannt nach
der Flimmerkiste und dem warmen Flimmern, das ein Bildschirm im dunklen Zimmer
verbreitet. Metadaten kommen von [TMDB](https://www.themoviedb.org/), die Daten
bleiben auf deinem Server.
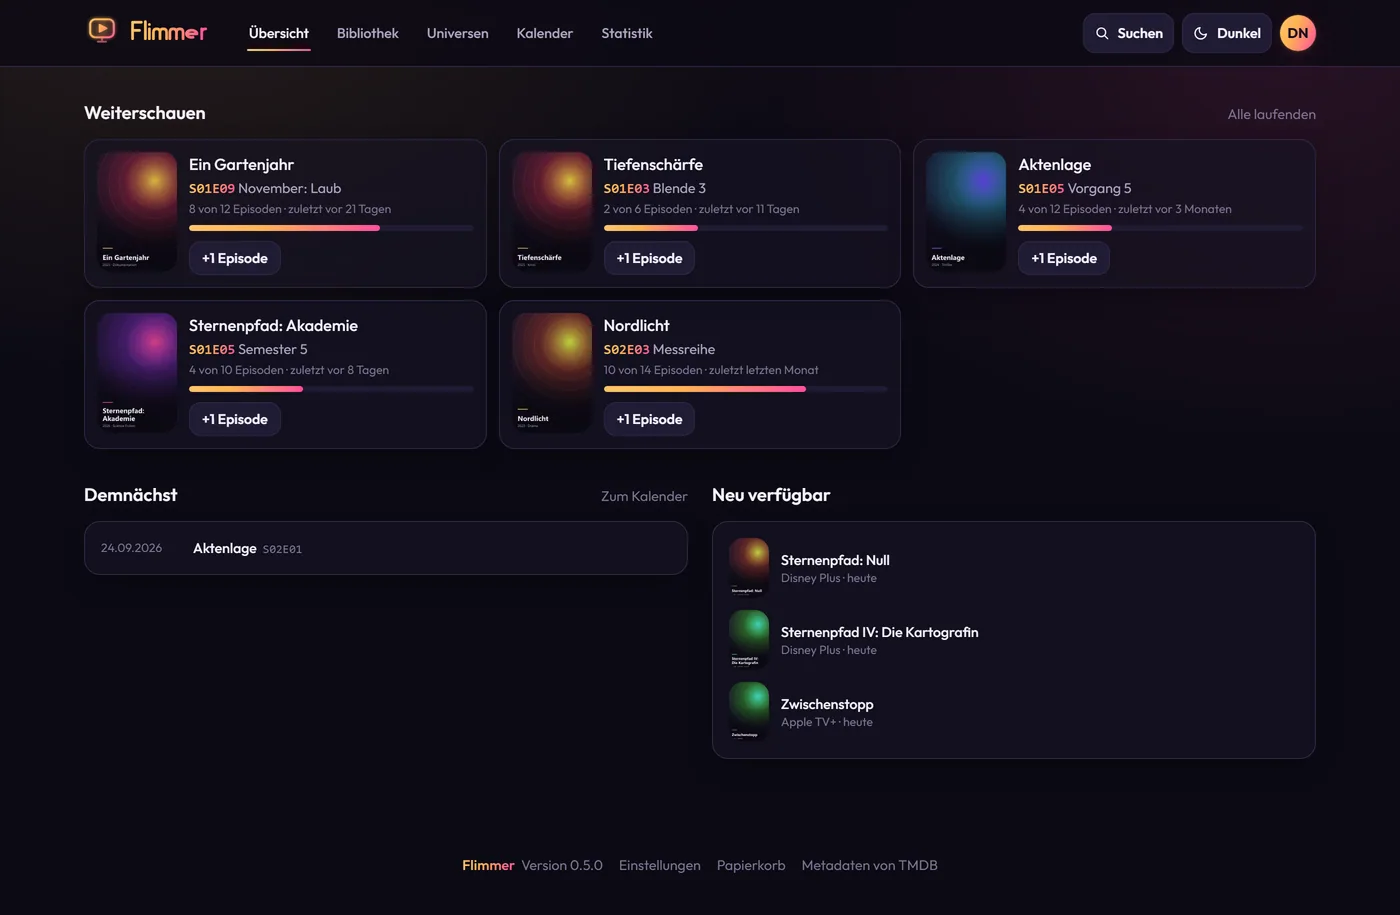
> **Bebilderte Anleitung:** [docs/ANLEITUNG.md](docs/ANLEITUNG.md) —
> führt einmal durch die ganze Anwendung.
> **Schnittstelle:** [docs/API.md](docs/API.md).
## Was Flimmer kann
- **Tracking** — Serien und Filme mit Status (Schaue gerade, Pausiert,
Abgeschlossen, Abgebrochen, Watchlist), Episodenfortschritt einzeln oder
staffelweise, „+1 Episode"-Knopf, Rewatch-Zählung, Bewertung, Notizen, Tags.
- **Universen** — MCU, Star Wars, Wizarding World … beliebige Filme *und* Serien
in einem Universum bündeln, mit mehreren Reihenfolgen (Erscheinung,
Story-Chronologie, Einsteiger-Route) und Gesamtfortschritt.
- **Metadaten von TMDB** — Suche, Poster, Staffeln und Episoden, offizielle
Collections, Streaming-Verfügbarkeit in deiner Region.
- **Eigene Sammlung** — markiere, was du schon hast, und wo: Jellyfin, Plex,
NAS, Blu-ray. Gerade die Titel, die nirgends mehr streamen, findest du so
wieder.
- **Benachrichtigungen** — bei neuen Episoden und Releases, per E-Mail, ntfy,
Gotify oder Webhook (Discord/Slack-kompatibel), pro Nutzer einstellbar.
- **Mehrere Nutzer** — jede Person hat ihre eigene Bibliothek; Universen lassen
sich teilen. Der erste registrierte Zugang wird Administrator.
- **Übersicht, Kalender und Statistik** — was als Nächstes dran ist, wann welche
Episode läuft, und wie viel Zeit wohin geflossen ist.
- **Import und Export** — aus Trakt.tv oder CSV hinein, als CSV oder JSON hinaus.
- **REST-API und PWA** — dokumentierte Schnittstelle mit eigenen API-Schlüsseln,
installierbar auf dem Startbildschirm, mit Offline-Rückfall.
- **Papierkorb statt Löschen** — 30 Tage Bedenkzeit, und jede Sichtung lässt sich
mit einem Klick zurücknehmen.
## Schnellstart
Voraussetzungen: Docker und Docker Compose.
```bash
git clone https://git.wilde-server.de/florian.wilde/flimmer.git
cd flimmer
cp .env.example .env
```
In der `.env` mindestens diese drei Werte setzen:
```dotenv
POSTGRES_PASSWORD=ein-langes-zufaelliges-passwort
AUTH_SECRET=noch-ein-langes-zufaelliges-geheimnis
APP_URL=https://flimmer.example.com
```
Geheimnisse erzeugen:
```bash
node -e "console.log(require('crypto').randomBytes(32).toString('hex'))"
```
Dann starten:
```bash
docker compose up -d
```
Flimmer läuft auf . Der **erste** Zugang, der sich
registriert, wird automatisch Administrator — lege ihn also gleich an. Danach
lässt sich die Registrierung in der Verwaltung schließen.
### TMDB-Schlüssel
Ohne TMDB findet die Suche keine Metadaten. Der Schlüssel ist kostenlos:
1. Konto auf [themoviedb.org](https://www.themoviedb.org/signup) anlegen
2. Unter *Einstellungen → API* einen Schlüssel beantragen
3. In die `.env` eintragen und `docker compose up -d` erneut ausführen:
```dotenv
TMDB_API_KEY=dein-schluessel
TMDB_REGION=DE
TMDB_LANGUAGE=de-DE
```
## Betrieb hinter einem Reverse Proxy
`APP_URL` muss auf die öffentliche Adresse zeigen — daraus werden Links in
Benachrichtigungen und der OIDC-Rücksprung gebildet. Als Healthcheck eignet
sich `/api/health`; der Endpunkt prüft auch die Datenbankverbindung.
Beispiel für Caddy:
```caddyfile
flimmer.example.com {
reverse_proxy flimmer:3000
}
```
## Aktualisieren
```bash
cd flimmer
./update.sh
```
Das Skript sichert zuerst die Datenbank, holt die Änderungen, baut das Image neu
und wartet, bis die Instanz wieder antwortet. Schlägt etwas fehl, nennt es den
konkreten Weg zurück — mit dem Befehl und der Sicherungsdatei, nicht bloß dem
Rat, ein Backup zu haben.
```
./update.sh --ohne-backup ohne Datenbanksicherung
./update.sh --ohne-pull nur neu bauen und starten
./update.sh --behalte 20 wie viele Sicherungen aufgehoben werden (Standard: 10)
./update.sh --hilfe
```
Die Sicherungen landen unter `backups/` und sind gzip-komprimierte `pg_dump`s.
Von Hand geht es genauso:
```bash
git pull && docker compose build && docker compose up -d
```
Datenbankmigrationen laufen in beiden Fällen automatisch beim Start des
Containers — ein eigener Handgriff ist nicht nötig.
## Backup
Alles, was zählt, steckt in der Datenbank; das Volume `flimmer-data` enthält
nur den Bild-Cache und lässt sich jederzeit neu aufbauen.
```bash
# Sicherung
docker compose exec -T db pg_dump -U flimmer -d flimmer --clean --if-exists \
| gzip > flimmer-$(date +%F).sql.gz
# Rückspielen
gunzip -c flimmer-2026-09-01.sql.gz \
| docker compose exec -T db psql -U flimmer -d flimmer
```
Für einen nächtlichen Lauf genügt ein Cron-Eintrag mit demselben Befehl.
Wer zusätzlich den Bild-Cache sichern will:
```bash
docker run --rm -v flimmer_flimmer-data:/data -v "$PWD":/backup alpine \
tar czf /backup/flimmer-data.tar.gz -C /data .
```
## Konfiguration
Sämtliche Einstellungen laufen über Umgebungsvariablen; die vollständige Liste
mit Erklärungen steht in [`.env.example`](.env.example). Die wichtigsten:
| Variable | Bedeutung |
|---|---|
| `APP_URL` | Öffentliche Adresse der Instanz |
| `AUTH_SECRET` | Geheimnis für Sitzungen — mindestens 32 Zeichen |
| `TMDB_API_KEY` | TMDB-Schlüssel für Metadaten |
| `TMDB_REGION` | Region für die Streaming-Verfügbarkeit (Standard `DE`) |
| `ALLOW_REGISTRATION` | Selbstregistrierung bei der Erstinbetriebnahme |
| `ENABLE_SCHEDULER` | Eingebauter Hintergrundlauf für Sync und Benachrichtigungen |
| `SMTP_*` | E-Mail-Versand |
| `OIDC_*` | Optionale SSO-Anbindung (Authelia, Keycloak, Authentik …) |
## Entwicklung
```bash
npm install
docker compose -f docker-compose.dev.yml up -d # nur PostgreSQL
cp .env.example .env # DATABASE_URL auf localhost:5439
npm run db:migrate
npm run db:seed # Demo-Konten
npm run dev
```
| Befehl | Wirkung |
|---|---|
| `npm run dev` | Entwicklungsserver |
| `npm run build` | Produktionsbuild |
| `npm run typecheck` | TypeScript prüfen |
| `npm run db:migrate` | Migration erzeugen und anwenden |
| `npm run db:studio` | Prisma Studio |
| `npm run db:seed` | Beispieldaten |
| `npm test` | Testlauf gegen die Entwicklungsdatenbank (braucht keinen TMDB-Schlüssel) |
| `npm run icons` | Favicon und PWA-Icons aus dem SVG-Logo neu erzeugen |
| `npm run screenshots` | Screenshots der Anleitung neu aufnehmen |
Ohne TMDB-Schlüssel lässt sich die Suche mit einem lokalen Ersatz ausprobieren,
der aus den Beispieldaten antwortet:
```bash
node --import tsx scripts/tmdb-stub.mjs 3099
TMDB_API_KEY=stub TMDB_BASE_URL=http://127.0.0.1:3099/3 npm run dev
```
Aufbau des Projekts:
```
src/
app/ Routen (App Router), API-Endpunkte, Server-Aktionen
components/ Wiederverwendbare Bausteine
lib/ Serverseitige Logik: DB, Auth, TMDB, Tracking, Statistik,
Universen, Benachrichtigungen, Abgleich, Import/Export
i18n/ Oberflächentexte
prisma/ Schema, Migrationen, Seed samt Beispielkatalog
tests/ Testlauf mit nachgebildeten TMDB-Antworten
public/brand/ Logo in allen Varianten
docker/ Entrypoint des Containers
docs/ Anleitung mit Screenshots, API, Design-Dokumentation
```
### Automatisierung
Unter `.gitea/workflows/` liegen zwei Abläufe für Gitea Actions: `ci.yml`
prüft bei jedem Push Typen, Tests und Produktionsbuild gegen eine echte
PostgreSQL-Instanz, `release.yml` legt beim Pushen eines Versions-Tags das
Release an — mit den Notizen aus `releases/vX.Y.Z.md`.
## Hintergrundlauf
Einmal täglich frischt Flimmer laufende Serien bei TMDB auf, meldet neue
Episoden, prüft die Verfügbarkeit von Watchlist-Titeln und leert den
Papierkorb. Gesteuert wird das über `ENABLE_SCHEDULER` und `SYNC_HOUR`.
Wer lieber einen eigenen Cron benutzt, setzt `ENABLE_SCHEDULER=false`, vergibt
ein `CRON_SECRET` und ruft auf:
```bash
curl -X POST -H "Authorization: Bearer $CRON_SECRET" https://flimmer.example.com/api/cron/sync
```
In der Verwaltung lässt sich der Lauf jederzeit von Hand anstoßen.
## Technik
Next.js (App Router) mit TypeScript, PostgreSQL über Prisma, Tailwind CSS.
Warum Next und nicht SvelteKit: Oberfläche, REST-API und Hintergrundläufe
stecken in **einem** Deployment, Server Components halten den Datenbankzugriff
serverseitig, und der `standalone`-Build ergibt ein schlankes Image ohne
Build-Werkzeuge. Für ein selbst gehostetes Werkzeug zählt vor allem, dass ein
einziger Container genügt.
## Lizenz
MIT — siehe [LICENSE](LICENSE).
Metadaten stammen von TMDB. Flimmer wird von TMDB weder betrieben noch
unterstützt.